Java Standard - 연산자(Operator)
다양한 연산자와 연산자가 동작하는 방식까지 알아보자.
Java Standard - 연산자(Operator)
연산자(Operator)
- 연산자(operator)
- 연산을 수행하는 기호, 피연산자로 연산을 수행하고 항상 결과값을 반환한다.
- 피연산자(operand)
- 연산자의 작업대상으로 연산자는 1~3개의 피연산자를 필요로 한다.
- 식(expression)
- 연산자와 피연산자를 조합해 계산하고자하는 바를 표현하는 것, 식을 계산해 결과를 얻는 것은 식을 평가한다고 한다.
- 대입 연산자
- 식을 평가해 얻은 결과를 변수와 같이 값을 저장할 수 있는 공간에 저장는 연산자
연산자의 종류
- 산술 연산자
- 사칙 연산과 나머지 연산,
+-*/%<<>>비교 연산자- 크고 작음, 같음과 다름을 비교,
><>=<===!= - 크고 작음, 같음과 다름을 비교,
- 논리 연산자
- 그리고와 또는 으로 조건을 연결,
&&||!&|^~ - 대입 연산자
- 우변의 값을 좌변에 저장,
= - 기타
- 형변환 연산자, 삼항 연산자, instanceof 연산자,
(type)?:instanceof
개수에 의한 종류
- 단항: 피연산자가 1개인 경우, 대표적으로 부호 연산자가 있다.
- 이항: 피연산자가 2개인 경우, 대부분 이항 연산자 이다.
- 삼항: 피연산자가 3개인 경우,
?:한개 뿐이다.
연산자의 우선순위와 결합규칙
- 우선순위
- 여러 연산자를 사용했을 경우, 연산 순서를 결정하는 순위
- 단항 → 이항 → 삼항
- 산술 → 비교 → 논리 → 대입
- 단항 → 이항 → 삼항
- 결합규칙
- 같은 우선순위의 연산자가 있을 경우, 연산의 진행 방향
- 단항 연산자, 대입 연산자의 진행 방향
←- 나머지 연산자의 진행 방향
→ - 단항 연산자, 대입 연산자의 진행 방향
산술 변환(usual arithemetic conversion)
산술 변환이란 연산 전에 피연산자 타입의 일치를 위해 자동으로 형변환 되는 것을 이야기하며, 단항 연산과 이항 연산에서 일어난다.
- 발생 규칙
- 두 피연산자의 타입을 같게 일치시킨다.(보다 큰 타입으로 일치) 값손실을 최소화하기 위해서
- 피 연산자 타입이 int보다 작은 경우, int로 변환 int가 가장 효율적으로 처리할 수 있는 타입이기 때문에 연산중에 오버플로우가 발생할 가능성이 높기 때문에
- 쉬프트 연산자
<<>>, 증감 연산자++--는 예외로 발생하지 않는다. - 피 연산자 타입이 int보다 작은 경우, int로 변환 int가 가장 효율적으로 처리할 수 있는 타입이기 때문에 연산중에 오버플로우가 발생할 가능성이 높기 때문에
단항 연산자
증감 연산자 ++ , --
- 증가 연산자
++ - 피연산자의 값을 1 증가시킨다.
- 감소 연산자
-- - 피연산자의 값을 1 감소시킨다.
- 위치
- 일반적으로 연산자는 피연산자의 왼쪽에 위치하지만, 증감 연산자는 왼쪽과 오른쪽 위치에 따라 결과가 다르다. 독립적으로 사용된 경우에는 결과에 차이가 없다.
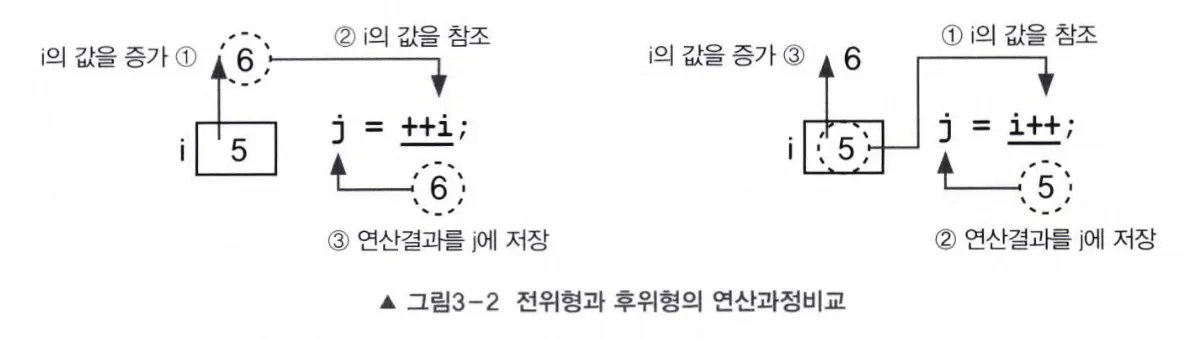
- 전위형: 값이 참조되기 전에 증가,
++i- 후위형: 값이 참조된 후에 증가,
i++식에 2번 이상 포함된 변수에 증감연산자를 사용하는 것은 피해야한다. (복잡함)
부호 연산자 + , -
- 부호 연산자
- - 피연산자의 부호를 반대로 변경한 결과를 반환한다.
- 부호 연산자
+ - 하는 일이 없으며,
-가 있으니 형식적으로+를 추가해 놓은 것 뿐이다.
boolean과char을 제외한 나머지에만 사용할 수 있다.
산술 연산자
사칙 연산은 일상생활에서 사용하는 것이라 주의할 사항을 중심으로 적어보겠다.
사칙 연산자 +, -, *, /
- 우선 순위
*→/→%→+→-- 나눗셈 연산자
/ - 피연산자가 정수형인경우, 나누는 수로 0을 사용하면 에러가 발생한다.
1
2
int a = 10;
int result = a / 0; // 에러 발생
- 두 피연산자가 int 타입인 경우, 연산결과가 int타입이기 때문에 소수점 이하는 버려진다.
1
2
3
int a = 10;
int b = 4;
System.out.println(a / b); // 연산 결과는 2.5가 아닌 2가 출력된다.
- 두 피연산자가 int 타입인 경우, 연산결과가 int타입이기 때문에 소수점 이하는 버려진다.
- 덧셈 연산자
+ - 피연산자가 int형보다 작을 때에는 int형으로 변환한 다음 연산을 때문에 연산 결과 역시 int형이 나오게 된다. 그래서 byte형의 덧셈을 하더라도 연산 결과는 int가 나오게 되어 byte형에 바로 대입을 할 수 없다.
1
2
3
4
byte a = 10;
byte b = 20;
// byte result = a + b; // 에러 발생
byte result = (byte) a + b;
- 곱하기 연산자
* - 피연산자의 두개가 int타입이라면, 결과도 int타입이기 때문에 연산결과가 int의 범위를 넘는 다면(=오버플로우가 발생한다면), 잘못된 결과값을 출력한다.
1
2
3
4
int a = 1_000_000;
int b = 2_000_000;
//long result = a * b; // a * b의 결과값은 int타입이고, 이후에 자동 형변환되는 것이다.
long result = (long) a * b;
- 문자의 사칙연산
- 문자도 사칙연산이 가능한데, 문자는 문자의 유니코드 값으로 바뀌어 저장됨으로 정수간의 사칙연산과 동일하다.
- 연산을 할 때에는 int타입으로 자동 형변환 되어 연산이 되기 때문에 결과는 int타입이다. 코드의 가독성과 유지보수를 위해 풀어쓰는 경우가 있는데, 풀어써도 컴파일러에 의해 미리 계산되기 때문에 실행 시의 성능 차이는 없다.
1
2
3
4
5
char a = 'a';
int b = a + 1;
char c = (char) b;
//char d = a + 1; //에러 발생
char d = 'a' + 1;
- 4에러가 발생하는 이유는, 연산 결과가 int타입이기 때문이다.
- 5에러가 발생하지 않는 이유는, 리터럴 간의 연산이기 떄문이다.
- 상수 또는 리터럴 간의 연산은 실행과정동안 변하는 값이 아니기 때문에 컴파일러가 컴파일시 그 결과로 대체함으로써 코드를 보다 효율적으로 만든다. 그렇게 때문에 연산 결과인 ‘b’ 라는 값을 변수 d에 저장한다.
나머지 연산자 %
- 나머지 연산자
% - 왼쪽의 피연산자를 오른쪽 피연산자로 나누고 난 나머지 값을 결과로 반환하는 연산자이다.
- 나누는 수(오른쪽 피연산자)로 0을 사용할 수 없다.
- 나누는 수(오른쪽 피연산자)로 음수도 허용하지만, 부호는 무시되어 절대값으로 나눈 결과와 같다.
- 나누는 수(오른쪽 피연산자)로 0을 사용할 수 없다.
비교 연산자
두 연산자를 비교하는데 사용되는 연산자로, 연산의 결과는 오직 true와 false 둘 중 하나이다. 비교 연산자도 이항 연산자이므로 피연산자의 타입이 다른 경우 자료형의 범위가 더 큰 쪽으로 자동 형변환해 타입을 일치시킨 후 비교한다.
대소비교 연산자 <, >, <=, >=
값의 크기를 비교하는 연산자로, 기본형의 boolean과 참조형에서는 사용할 수 없다.
종류
>- 좌변 값이 크면 true, 아니면 false
<- 우변 값이 크면 true, 아니면 false
>=- 좌변 값이 크거나 같으면 true, 아니면 false
<=- 우변 값이 크거나 같으면 true, 아니면 false
- 형변환 과정 예시
'A' > 'B'—(유니코드로 변환)→65 > 66—(연산)→false
등가비교 연산자 ==, !=
값이 같은지, 다른지를 비교하는 연산자로, 모든 자료형에 사용할 수 있다.
- 비교 대상
- 기본형 - 변수에 저장된 값이 같은지를 비교
- 참조형 - 같은 객체를 가리키고 있는지를 비교
- 기본형과 참조형은 서로 형변환이 가능하지 않기 때문에, 서로를 비교할 수는 없다.
- 참조형 - 같은 객체를 가리키고 있는지를 비교
형변환 과정 예시
1
2
3
4
5
 `'A' == 'B'`  —(유니코드로 변환)→ `65 == 66` —(연산)→ `false`
 `10 == 10.0f`  —(형변환)→ `10 == 10.0f` —(연산)→ `true`
 `10.0 == 10.0f`  —(형변환)→ `10.0 == 10.0` —(연산)→ `true`
 `0.1 == 0.1f` —(형변환)→ `0.1 == 0.1` —(연산)→ `false`
 `(float)0.1 == 0.1f` —(형변환)→ `0.1 == 0.1` —(연산)→ `true`
- 3
10.0f은 오차없이 저장이 가능한 값이라 double로 형변환을 해도 그대로10.0이 된다. - 4
0.1f은 저장할 때 2진수로 변환하는 과정에서 오차가 생기기고, double형에서도 오차가 발생하지만 float형보다 더 적은 오차가 발생하기 때문에 서로 다른 값으로 저장되어 결과가 false가 나오게 된다. - 5앞의 예제에서는 자동 형변환이 일어난 것이라 값의 범위가 더 넓은 double로 형 변환이 되어 다른 값이 되는데, double 형을 float 형으로 형변환을 한다면 0.1이 같은 오차로 저장되기 때문에 결과가 true가 나오게 된다.
문자열을 비교시에는
==연산자가 아닌equals()를 사용해야한다.==은 같은 객체인지를 확인하는 메서드이기때문에, 문자열 내용이 같아도 false를 반환 할 수 있다.
논리 연산자
논리 연산자는 둘 이상의 조건을 그리고 나 또는 으로 연결하여 하나의 식으로 표현 할 수 있도록해준다.
논리 연산자 &&, ||, !
- AND연산
&& 그리고에 해당하며, 두 피연산자가 모두true일 때만true를 결과로 얻는다.- 효율적인 연산 - 좌측 피연산자가 false라면 우측 피연산자의 값은 평가하지 않는다.
- OR연산
|| 또는에 해당하며, 두 피연산자 중 한쪽만true이여도true를 결과로 얻는다.- 우선순위는
&&연산자가 먼저지만, 한 문장에&&와||가 여러번 포함된 경우에는 괄호를 사용해 우선순위를 명확히 해주는 것이 좋다.- 효율적인 연산 - 좌측 피연산자가 true라면 우측 피연산자의 값은 평가하지 않는다.
- 우선순위는
- 논리 부정 연산자
! true와false를 반대로 바꾸는 결과를 반환하며, 피연산자와 가까운 것부터 연산된다.
비트 연산자 &, |, ^, ~, «, »
- 피연산자를 비트단위로 논리 연산을 한다.
- 피연산자로는 정수형(문자포함)만 허용된다.
- 산술변환이 일어날 수 있다.
- OR연산
| - 피연산자 중 한 쪽의 값이 1이면, 1을 결과로 얻고 그 외에는 0을 얻는다.
- 특정 비트의 값을 변경할 때 사용된다.
- AND연산
& - 피연산자 모두 1이어야 1을 결과로 얻고 그 외에는 0을 얻는다.
- 특정 비트의 값을 뽑아낼 때 사용된다.
- XOR연산
^ - 피연산자의 값이 서로 다를때만 1을 결과로 얻고 그 외에는 0을 얻는다.
- 간단한 암호화에 사용된다.
- 비트 변환 연산자
~ - 피연산자를 2진수로 표현했을때 0과 1을 바꾼다. 즉, 피연산자의 1의 보수를 얻게한다.
- 쉬프트 연산자
<<,>> - 피연산자의 각 자리를 왼쪽
<<또는 오른쪽>>으로 이동시킨다.- 이동시의 빈칸은 0으로 채우고,
>>연산시 부호가 있는 정수인경우에는 1로 채운다.- 산술변환이 적용되지 않는다.
x << n=x * 2ⁿ,x >> n=x / 2ⁿ- 연산의 속도가 빠르다. 다만 가독성이 떨어지니 실행속도가 요구되는 곳에서만 사용하는것이 좋다.
- 이동시의 빈칸은 0으로 채우고,
그 외의 연산자
- 조건 연산자 ? :
- 조건식, 식1, 식2 이렇게 3개의 피연산자를 요구하는 삼항 연산자이다.
- 조건식에 따라 다른 결과를 반환하는데, 조건식의 결과가 true면 식1, false면 식2가 반환된다.
- 간단한 if문을 대신해서 쓸 수 있고, 코드가 간략해 질 수 있지만, 너무 여러변 중첩해서 사용하면 가독성이 떨어지니 꼭 필요한 경우에 한번 정도만 중첩하는 것이 좋다.
- 조건식에 따라 다른 결과를 반환하는데, 조건식의 결과가 true면 식1, false면 식2가 반환된다.
- 대입 연산자
= - 대입 연산자는 변수와 같은 저장공간에 값 또는 수식의 연산결과를 저장하는데 사용된다.
- 대입 연산자는 가장 낮은 우선순위를 가지고 있다.
- lvalue와 rvalue
- 대입연산자의 왼쪽 피연산자를 lvalue, 오른쪽 피연산자를 rvalue라고 한다.
- rvalue는 변수, 식, 상수 등 모두 가능하지만, lvalue는 반드시 변수처럼 값을 변경할 수 있는 것이여야한다.
- 복합 대입 연산자
op= - 다른 연산자(op)와 결합해
op=와 같은 방식으로 사용할 수 있다.
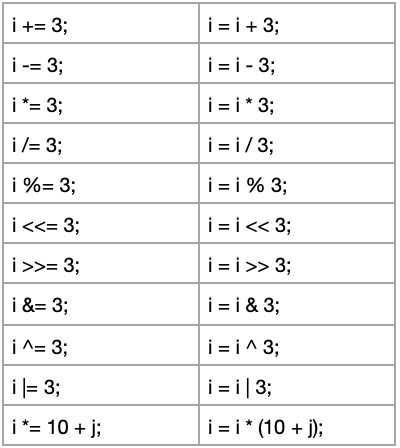 복답 대입 연산자 종류
This post is licensed under CC BY 4.0 by the author.